
Reconstruire une plateforme de 20 sites comme un exercice de routine
L'un de nos client exploite une vingtaine de sites web vitrines et moteurs de réservation de tout un réseau de villages vacances. Chacun de ces sites est un point de contact commercial direct : une indisponibilité, même brève, se traduit immédiatement en réservations perdues et en image écornée.
Ces sites reposent actuellement sur une plateforme kubernetes mutualisée chez un prestataire marseillais. Afin de faire face à une défaillance grave, notre client nous a contacté pour réaliser une plateforme similaire de PRA (Plan de Reprise d’Activité) avec un temps d’indisponibilité le plus court possible. Nous avons donc proposé une solution avec notre partenaire historique Scaleway.
D’ailleurs, le mot « sites » simplifie d’ailleurs une réalité plus large : une bonne vingtaine de sites vitrines drupal qui gravitent avec des services partagés, une connexion à des espaces professionnels, des dépôts logiciels métier spécifiques, une passerelle d’envoi d’e-mails, la redirection des anciennes adresses issues de précédents outils pour le SEO… C’est au total un écosystème d’une trentaine d’environnements actifs en permanence, chacun avec ses propres exigences de disponibilité.
Le point de départ
Il faut être honnête sur le point de départ : nous n’avons pas hérité d’une infrastructure de production à dupliquer à l’identique : se serait trop simple !
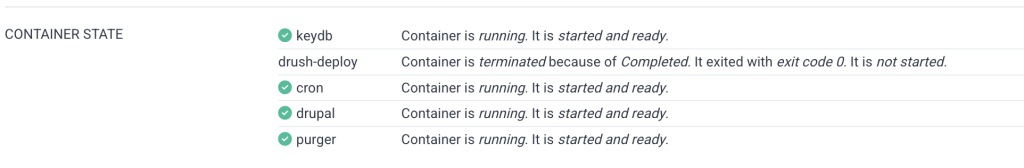
Le seul artefact transmis était la stack de développement docker de l’un des sites. Cette stack fonctionnait très bien pour ce à quoi elle avait été conçue. Mais rien, dans sa construction d’origine, ne la préparait à faire tourner vingt sites à la fois, à encaisser un pic de réservations un lundi de vacances, à survivre à la panne d’un serveur, ou à être reconstruite sur commande. Il a fallu la décortiquer entièrement : comprendre comment chaque composant du site assemblait son contenu, son cache de performance, sa configuration puis retraduire cette même logique dans une architecture distribuée, redondante, rejouable et surtout : sans jamais toucher au contenu des images docker fournies à la plateforme actuelle.
C’est un vrai travail de traduction, pas un simple copier-coller. Le défi a été de bâtir, dans un environnement différent et en utilisant les composants disponibles sans les modifier, une plateforme de production stable et scalable.
L’enjeu clef
Une sauvegarde répond à une question : « ai-je une copie de mes données ? ». Un Plan de Reprise d’Activité en pose une autre, bien plus exigeante : « suis-je capable de faire revivre l’intégralité de ma plateforme, sans improviser le jour où j’en ai vraiment besoin ? »
Un plan de reprise qui n’a jamais été testé n’est qu’une hypothèse.
C’est précisément l’objectif ici : une procédure de reconstruction complète : infrastructure, bases de données, sécurité, sites... conçue pour être rejouée à tout moment, pas seulement documentée sur le papier. La meilleure façon de garantir qu’un plan de secours fonctionne le jour où il devient nécessaire, c’est de l’exécuter régulièrement, à froid, en conditions réelles.
Ce qui a été fait
Voici la reconstruction telle qu’elle sera jouée, sans rien sauter : la même séquence que nous suivrons lors d’un incident réel.
- Les Fondations : Le socle technique : réseau, cluster kubernetes, bases de données, bastion sécurisé… recréés intégralement à partir de sa description, sans dépendre d’une sauvegarde de configuration ni de la mémoire d’une personne (Terraform).
- Restauration des données : Les données de l’ensemble des sites doivent être restaurées deux fois : une fois pour la plateforme en production, une fois pour un environnement de test identique, utilisé pour valider chaque changement avant qu’il n’atteigne les visiteurs.
- Mise en service et contrôle : Les vingt sites principaux doivent être activés rapidement et de manière reproductible avec leurs certificats de sécurité délivrés automatiquement. (ArgoCD / Cert-manager) Notez que chaque adresse de site a été vérifiée une à une avant d’être déclarée opérationnelle.
L’architecture, en quelques mots
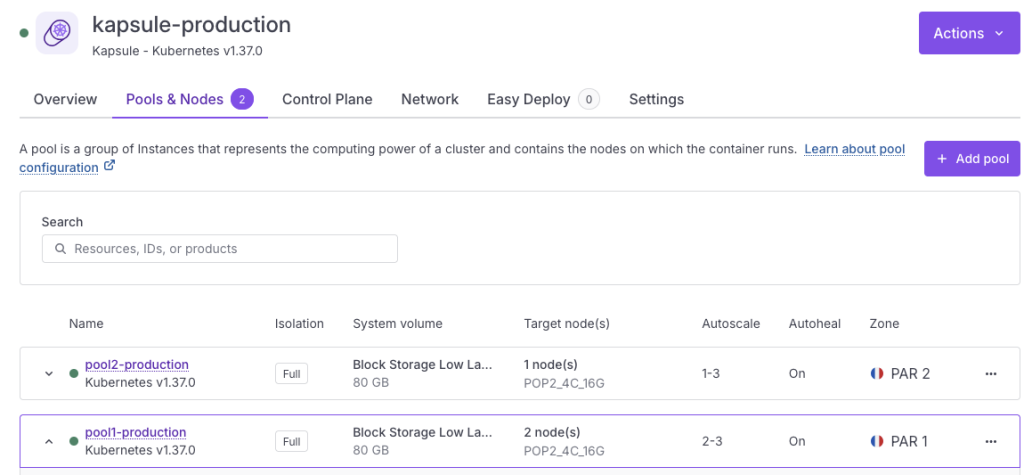
Sans entrer dans le détail technique, six choix structurent la résilience de cette plateforme :
- Des sites autonomes : Contenu, cache et vitesse, séparés. Un site n’est pas un bloc unique : le contenu géré par les équipes marketing, la couche qui absorbe les pics de fréquentation, et la mémoire rapide qui accélère l’affichage des pages tournent séparément pour que la panne ou la lenteur de l’un n’entraîne pas les autres et les différents site sont répartis sur différents serveurs selon la charge (flexibilité et réservation automatique de ressources complémentaires)
- Plusieurs marchés : Un site mais plusieurs langues. Chaque site se décline dans les langues de ses clientèles : française, britannique, allemande, italienne, néerlandaise… Chaque déclinaison peut avoir une porte d’entrée commerciale à part entière, avec sa propre adresse et son propre certificat de sécurité.
- Hébergement : Tout est déposé sur un cloud souverain français (c’est la norme chez nous). Les données, les images et les sites restent hébergés en France, chez notre partenaire Scaleway. Un choix de souveraineté, d'écologie autant que de conformité.
- Reproductibilité : Une plateforme décrite, pas bricolée. Toute l’infrastructure est entièrement décrite précisément dans des fichiers. Elle peut donc être recréée à l’identique, par n’importe qui autorisé, à n’importe quel moment.
- Environnement miroir inclus : Un terrain d’essai grandeur nature. Un second environnement, plus petit afin de permettre de tester chaque évolution en conditions réelles avant qu’elle ne touche un seul visiteur.
- Mise en production — Des déploiements automatisés et tracés. Chaque changement validé se déploie de lui-même, dans un ordre contrôlé, avec une trace complète de ce qui a été fait et quand.
La rapidité, en chiffres
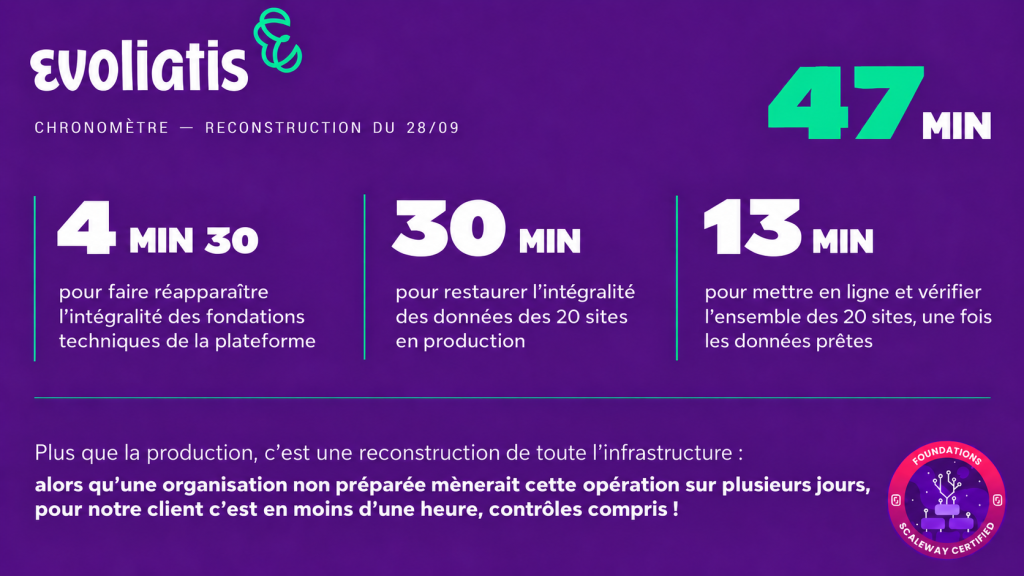
Ce chronométrage couvre le retour en production. Par prudence, la procédure existe aussi pour un environnement de test (c’est la règle chez Evoliatis) : rien n’atteint les visiteurs sans être validé d’abord.
Le rôle de conseil d’Evoliatis
Presque n’importe quel prestataire peut relancer une infrastructure si le travail en amont a bien été fait. La valeur d’Evoliatis se mesure à ce qui se passe autour de l’exécution : avant mais aussi pendant, et après.
- Adapter, pas copier : pour rappel, le seul élément hérité était une stack pensée pour un poste de développeur, pas pour la production. Plutôt que de le déployer tel quel, nous l’avons entièrement retravaillée pour tenir la charge et le sinistre, sans jamais imposer aux équipes de développement de changer leur façon de travailler.
- Diagnostiquer : Beaucoup de “petits points faibles silencieux” ont été identifiés. Ces petits désagréments qui pourraient se révéler très lourds à gérer en période de crise. Ainsi, nous avons remarqué que l’adresse publique du frontal web changeait à chaque reconstruction. Un détail ? C’est vrai, mais nous en avons cherché la cause pour le corriger durablement plutôt que de contourner le problème en attendant qu’il se reproduise.
- Vérifier, toujours : Rien n’a été déclaré « terminé » sans contrôle : chacune des vingt bases de données a été validée avant d’être restaurée, chaque adresse de site a été testée individuellement, chaque accès sécurisé a été éprouvé en conditions réelles. Plusieurs montées de version ont été validées. Aucune supposition, que du fonctionnel.
- Prendre le temps utile : L’environnement de test a aussi été reconstruit et validé systématiquement, avant que la même procédure ne soit appliquée à la production. Une prudence qui coûte quelques minutes et qui évite des heures d’indisponibilité.
- Laisser la documentation vivante : Chaque procédure a été mise à jour pour refléter les évolutions, avec l’instruction explicite de toujours vérifier la version la plus récente des outils utilisés plutôt que de se fier à une note qui peut dater : la prochaine reconstruction se doit d’être toujours plus sûre que la précédente, jamais identique par habitude. Les mises à jour de sécurité n’attendent pas !
En résumé
Le PRA demandé par notre client n’est pas une assurance qu’on espère ne jamais devoir activer : c’est une procédure vivante, retestée régulièrement en conditions réelles, qui a prouvé que le jour J, elle tiendrait toutes ses promesses : remettre en ligne l’intégralité d’un réseau de 20 sites / 30 stacks mais sans panique et sans improvisation.
C’est cette différence : entre avoir un plan et savoir qu’il fonctionne qui change tout !
RETOUR